

Comment le RAG transforme l'accès aux connaissances dans les administrations du monde entier
23 systèmes RAG publics, douze pays : ce qui fonctionne, ce qui s'arrête, et les quatre preuves que presque personne ne publie.
Sommaire
- 1. Un problème mondial, pas un problème de modèle
- 2. Quatre objets à ne pas confondre
- 3. Trois modèles d’organisation
- 4. Ce que les services en production montrent
- 5. Ce que les pilotes avouent
- 6. Les quatre preuves manquantes
- 7. Pourquoi le RAG reste la bonne réponse
- 8. Ce que cela change pour un projet public
- 9. Ce que la série va montrer
- 10. Conclusion
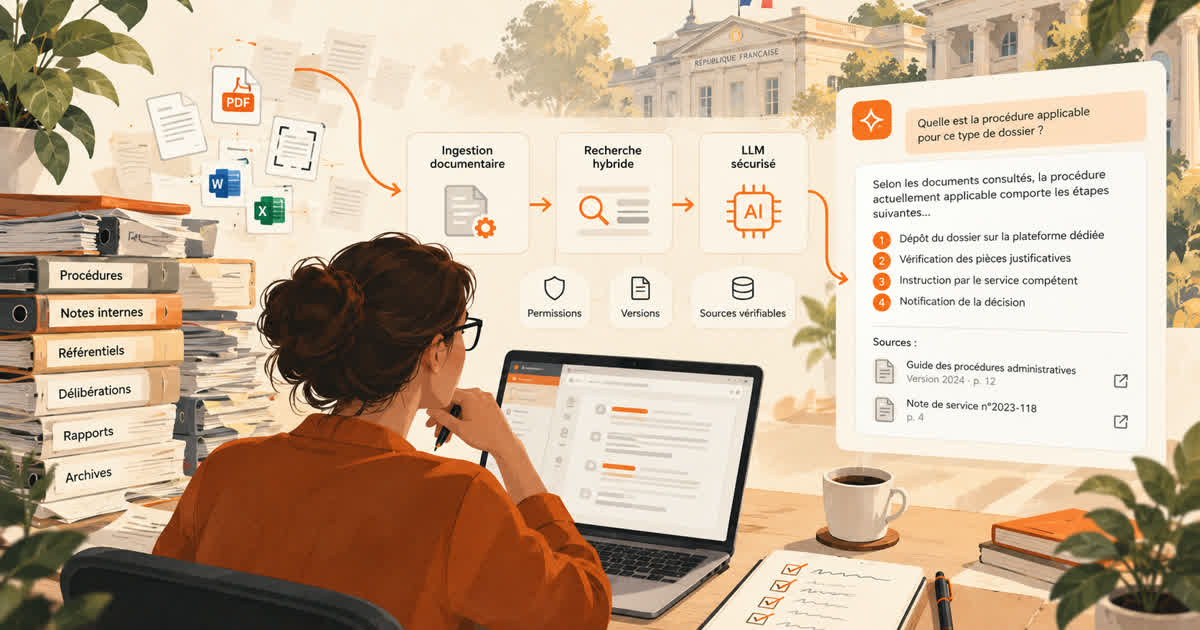
Un agent doit répondre à une question simple : quelle procédure s’applique aujourd’hui à ce dossier ? La réponse existe. Elle est probablement dans un PDF, peut-être dans deux, sans doute dans une version qui n’est plus en vigueur. Le problème n’est pas que l’administration manque d’information. C’est qu’elle en a trop, répartie dans trop d’endroits, sans que personne puisse dire lequel fait foi.
Premier article d’une série de cinq. Celui-ci dresse le panorama et pose la thèse ; les quatre suivants ouvrent le capot.
1. Un problème mondial, pas un problème de modèle
La dispersion documentaire n’est pas une singularité française. En France, d’après une enquête de la Cour des comptes de 2017, 16 % seulement des archives de l’État sont conservées aux Archives nationales ; plus de 60 % le sont dans les archives départementales 1. Les Archives nationales représentent 395 kilomètres linéaires, 135 téraoctets et 14,9 millions de documents numérisés accessibles en ligne 2. Ce ne sont pas des chiffres de saturation : ce sont des chiffres de répartition. Le document qui répond à la question existe, mais il faut savoir dans quel silo, dans quelle version et sous quelle autorité le chercher.
Ailleurs, la même structure apparaît sous d’autres formes. Chez KIRA, en Allemagne, l’analyse d’un contrat de projet informatique suppose de recouper des pièces réparties entre plusieurs documents 3. Chez Digdir, en Norvège, l’outil chargé d’extraire des mesures de documents stratégiques bute d’abord sur l’hétérogénéité des formats 4. Au Brésil, le guide public sur le RAG place les normes révoquées parmi les premiers risques : un document encore présent dans la base peut avoir perdu toute valeur juridique 5. Trois pays, trois métiers, un même constat : le corpus est le problème, bien avant le modèle.
Combien de temps cette recherche coûte-t-elle ? Personne ne le mesure. JuriScope, projet d’investigation du ministère des Affaires étrangères, évoque 40 à 60 % du temps de certains projets consacré à la recherche documentaire, sans protocole permettant d’en faire un chiffre général 6. La Cour des comptes, de son côté, établit que les dispositifs existants ne permettent ni de s’engager fermement sur les gains de productivité des projets numériques, ni de les mesurer de façon fiable 7. C’est une précision importante : le coût du problème est documenté qualitativement, pas quantitativement. Quiconque avance un pourcentage de temps perdu doit dire d’où il le sort.
Ce que cet article ne prétend pas
Il ne promet pas de gain moyen démontré : aucun n’est publié. Il ne promet pas la conformité automatique : un RAG ne vérifie pas qu’une norme est applicable. Il ne promet pas la souveraineté par le seul hébergement : un système « on-premise » peut être moins traçable qu’un cloud sous contrat. Il ne promet pas l’infaillibilité : les systèmes qui fonctionnent sont bornés. Il ne donne pas de coût unitaire : aucun cas public n’en publie.
Note de méthode. Le corpus de cet article compte 23 systèmes ou projets RAG répartis dans douze pays, plus trois institutions européennes (quatre projets). Une source n’y entre que si elle nomme explicitement le RAG, ou décrit sans ambiguïté le cycle « recherche documentaire → génération ». Les cas frontière (le chatbot Pair à Singapour, Jüri en Estonie, Hankintavälkky en Finlande) sont cités comme contre-exemples, jamais comptés comme des RAG. Toutes les pages ont été consultées le 19 octobre 2026 ; les statuts sont ceux des sources, pas une actualisation de terrain.
2. Quatre objets à ne pas confondre
Le mot « chatbot » recouvre aujourd’hui quatre choses différentes, et la confusion est la première source d’erreur dans les projets publics.
| Objet | Ce qu’il fait | Exemple | Ce qu’il ne fait pas |
|---|---|---|---|
| Chatbot d’information | répond à partir de contenus publics ou d’un arbre de décision | Ask Laura, El Paso, arrêté 8 | ne cite pas de corpus métier, ne s’abstient pas |
| Assistant généraliste | rédige, résume, conversation libre | Pair, Singapour 9 ; L’Assistant, France 10 | ne garantit pas l’ancrage documentaire |
| Recherche sémantique | retrouve des passages proches d’une question | Jüri, Estonie, selon une source secondaire 11 | ne génère pas de réponse rédigée |
| RAG documentaire | recherche des passages, les donne au modèle, cite les sources | Assist 12, China Maritime 13, KIRA 3 | ne rend pas le modèle infaillible |
La démonstration la plus économique vient de Singapour. GovTech y exploite deux produits que tout le monde appelle « chatbots IA » : AIBots et Pair. AIBots est décrit comme un système de génération augmentée par récupération, sur des documents internes pouvant aller jusqu’au niveau Restricted / Sensitive 14. Pair est un assistant génératif, sans récupération documentaire décrite 9. Les deux rendent service ; un seul est un RAG. La différence n’est pas cosmétique : elle détermine ce qu’on peut exiger du système en matière de citation, de permissions et d’abstention.
En Finlande, Hankintavälkky illustre une autre frontière. L’assistant du portail des marchés publics est bien en service, avec environ 700 discussions par mois fin 2024 et des retours favorables 15. Mais aucune source ne décrit son architecture comme un RAG. L’appeler « RAG » serait une commodité de langage, pas un fait. La même prudence vaut pour Jüri : le chiffre de 83 % de questions courantes traitées vient d’une source secondaire 11.
Cette clarification n’est pas un exercice de vocabulaire. Un chatbot qui ne cite pas ne peut pas être audité. Un assistant généraliste qui ne s’abstient pas ne peut pas être déployé sur des procédures sensibles. Un RAG qui ne filtre pas les droits n’est pas un outil documentaire : c’est une fuite en attente. Les exigences ne sont pas les mêmes, et le budget non plus.
3. Trois modèles d’organisation
Le panorama ne se lit pas comme une échelle de maturité, du pays le plus avancé au moins avancé. Il se lit selon trois façons d’organiser le service. Un même pays peut les pratiquer toutes les trois.
1
Plateforme mutualisée
Un opérateur outille ; les agences versent leurs corpus.
- AIBots · Singapour115 agencesService
- Caroline du Nordwidget d’agenceService
- Albert API · France70+ projetsService
2
Produit métier
Une équipe, un corpus, un métier.
- Assist · Royaume-Uni5 documentsService
- China Maritime5 488 questions-réponsesService
- Seoul Data Hubdonnées municipalesService
- GSA Leasing Botguide interneService
- KIRA · Allemagnecontrats informatiquesPilote
3
Guide et capacités
Un document, pas un système : il diffuse, il n’exécute pas.
- GOV.UK AI Insightsdeux guidesService
- Brésil · MGIguide publicService
- Rwanda · Policy Navigatorprojet primé, non déployéProjet
La plateforme mutualisée. Un opérateur central fournit l’outillage, les agences apportent leurs documents. AIBots, à Singapour, revendique 40 000 utilisateurs, 115 agences, 12 000 bots et plus d’un million de messages sur la période août 2024 – février 2025 14. La Caroline du Nord propose un widget d’information aux agences de l’État, hébergé et maintenu par NCDIT 16. En France, Albert API expose génération, RAG, vectorisation, reranking et OCR, avec plus de 70 projets publics et plus de 100 000 requêtes par semaine. Ces chiffres sont ceux de l’opérateur, non audités 17.
Le produit métier. Une équipe, un corpus, un métier. Assist, au Royaume-Uni, aide les communicateurs publics à rédiger et relire, sur cinq documents de référence explicitement maintenus 12. China Maritime répond à des questions réglementaires pour les marins et les entreprises, sur une base de 5 488 questions-réponses 13. Seoul Data Hub interroge les données publiques municipales en langage naturel 18. KIRA analyse des contrats de grands projets informatiques, en local, pour le compte de l’ASDN 3.
Le guide et les capacités. Un document, pas un système. Le GOV.UK AI Insights publie deux guides sur le RAG, dont un sur le RAG agentique 19, 20. Le Brésil publie un guide d’introduction au RAG dans le secteur public, qui traite des normes révoquées 5. Le Rwanda a conçu un Policy Navigator primé au sommet AI for Good 2026, sans mise en service établie 21.
Chaque modèle règle un problème et en laisse un autre intact. La plateforme règle la mise à disposition, pas la qualité des corpus versés. Le produit métier règle la précision sur un périmètre étroit, pas la réutilisation par d’autres services. Le guide règle la diffusion des pratiques, pas l’exécution. C’est pourquoi un pays peut avoir, simultanément, une plateforme nationale, un produit métier qui fonctionne et un guide : ce ne sont pas trois étapes, ce sont trois réponses à trois contraintes différentes.
Le piège, en écrivant un panorama, est de classer les pays. La France a une plateforme (Albert API) et des expérimentations métier (Loiret, RAGaRenn) 17, 22. Le Royaume-Uni a un guide (GOV.UK) et un produit (Assist). Singapour a une plateforme (AIBots) et un assistant généraliste (Pair), qui n’est pas un RAG. Un tableau par pays donnerait une fausse impression de progression ; un tableau par modèle donne une grille de décision.
4. Ce que les services en production montrent
Six cas permettent de voir ce qu’un service public en production publie réellement, et ce qu’il ne publie pas.
AIBots (Singapour). Le système est en production à l’échelle du gouvernement, sur le réseau gouvernemental, avec des documents classifiés. Ce qu’il publie : des volumes d’adoption. Ce qu’il ne publie pas : la moindre mesure de qualité. On ne sait pas quel taux de réponses justes il atteint, ni comment les permissions descendent jusqu’aux fragments 14. C’est le paradoxe du cas le plus cité du corpus : sa réussite est organisationnelle, pas documentée techniquement.
Assist (Royaume-Uni). C’est le cas le plus complet. Le registre de transparence algorithmique décrit un RAG combiné à l’API GOV.UK Search, avec citations, sur cinq documents de référence 12. Le service revendique environ trois heures gagnées par semaine et 98 % d’utilité déclarée auprès de 8 500 agents en juillet 2026. La méthode n’est pas publiée. L’hébergement repose sur AWS Bedrock, avec un compte « escrow » empêchant le fournisseur d’accéder aux données 12. C’est mieux documenté que la moyenne, et ce n’est toujours pas une évaluation : ni jeu de questions, ni rappel, ni taux de citation exacte.
China Maritime. Le ministère des Transports publie un chiffre rare : plus de 90 % de précision annoncée, sur 3 570 réponses, depuis le 25 juin 2025 13. Le protocole n’est pas publié, l’échantillon n’est pas décrit, le taux d’abstention est absent. Le système prévoit une double vérification et un transfert humain. C’est un service métier réel, avec un chiffre, mais un chiffre qui ne permet pas de comparaison.
Seoul Data Hub. 67 300 consultations, 13 800 utilisateurs, environ 80 % de satisfaction, d’après un communiqué de la ville de février 2025 18. La méthode d’enquête n’est pas publiée. La satisfaction mesure l’expérience, pas l’exactitude. Un utilisateur peut être satisfait d’une réponse fausse si elle est fluide.
Ask the EP Archives. Le Parlement européen rend interrogeables plus de 100 000 documents historiques, de 1952 à 1994, avec traduction automatique dans 55 langues 23. Aucune métrique n’est publiée. C’est un cas remarquable par la couverture linguistique et par l’ancienneté du corpus ; il ne dit rien de la qualité des réponses.
ECBot (BCE). Le chatbot grand public combine des réponses prédéfinies et une couche RAG pour les questions ouvertes ; il affiche trois sources principales, et l’infrastructure IBM Watson Discovery est située en Allemagne et en Roumanie 24. C’est un exemple de RAG « seconde couche » : le RAG n’est pas le produit, il rattrape les questions que l’arbre décisionnel ne couvre pas.
À quoi s’ajoute un contre-exemple utile : la GSA américaine déclare un Leasing Desk Guide Bot déployé, un Pricing Policy Chatbot en pilote et LaborMatch IQ en pré-déploiement (trois statuts pour trois cas, dont aucun ne publie de bénéfice mesuré) 25. Le miroir analytique de l’inventaire fédéral ne renseigne aucune des huit questions de gouvernance suivies 26.
Les inventaires américains illustrent l’écart à l’échelle fédérale. Le GAO mesure une adoption spectaculaire (32 cas d’usage recensés en 2023, 282 en 2024) et, dans le même rapport, les obstacles : ressources techniques et budgétaires, mise à jour des règles d’usage, confidentialité 27. La NARA documente une recherche en langage naturel en production et un étiquetage automatique d’environ deux millions de documents, sans architecture RAG décrite ni métrique d’impact 28. Le Department of Labor déclare deux outils déployés sans publier un seul chiffre 29. Un inventaire dit qu’un système existe ; il ne dit pas qu’il fonctionne.
Le fil conducteur de tous ces cas tient en une phrase : l’usage est prouvé, la qualité ne l’est pas. On sait combien de personnes utilisent, combien de questions sont posées, combien de documents sont indexés. On ne sait presque jamais si la réponse est juste, complète et applicable.
5. Ce que les pilotes avouent
Les pilotes sont plus instructifs que les succès, parce qu’ils disent où le projet s’arrête.
Minnesota. La plateforme nebulaONE devait permettre aux agences de l’État de prototyper des chatbots et des RAG sur des données de niveau Low et Moderate. Le projet a coûté 64 000 $ au fonds TMF et a été clos le 11 mars 2025, sans résultat publié 30. Ce n’est pas un échec documenté : c’est un arrêt sans bilan. La différence compte pour quiconque cherche un retour d’expérience.
KIRA (Allemagne). Le prototype a été présenté en mars 2025, avec un MVP prévu fin août et un usage quotidien envisagé au quatrième trimestre 2025. Aucune confirmation n’a suivi 3. Le cas est pourtant intéressant : il est on-premise, sur des contrats sensibles, avec des citations. Il montre que la contrainte de confidentialité peut être traitée, pas qu’elle l’a été à l’échelle.
Rwanda. Le Policy Navigator de RISA a reçu une distinction internationale en 2026, pour un périmètre annoncé de 50 agents et 24 institutions. La mise en service n’est pas établie 21. Un prix n’est pas un déploiement ; c’est une reconnaissance de conception.
Kenya. GovBot est un pilote 2024–2026, avec une architecture détaillée : ChromaDB, LlamaIndex, PydanticAI, citations et scores de confiance 31. C’est l’un des rares cas où l’architecture est publique. Aucune métrique d’usage ou de qualité ne l’est.
JRC (Commission européenne). Deux démonstrateurs : l’analyse de crises, en décembre 2024, et les garanties nucléaires, en septembre 2026 32, 33. Tous deux s’adressent à des analystes ; le second prévoit une revue humaine. Ce sont des démonstrateurs, pas des services.
Japon et Inde. SEABIS, l’assistant de l’Agence numérique japonaise, a été présenté en démonstration le 25 juin 2025, avec citations et numéros de page, sans déploiement 34. En Inde, le défi NFRA est un appel à propositions, pas un système 35.
Network Rail (Royaume-Uni). Le cas est techniquement abouti et pas encore en service. Le chatbot de leçons apprises repose sur Azure AI Search et Azure OpenAI, avec citations ; la preuve de concept a pris quatre à cinq semaines, le chatbot était interrogeable au bout de deux semaines, et neuf semaines ont servi à consolider sécurité, infrastructure et formats 36. Aucun gain, aucune adoption, aucune précision ne sont publiés. Un chiffre circule pourtant : les 29 000 heures par an et les quelque trois millions de livres attribués à Network Rail concernent une autre démarche, sur les données de la région Wales & Western, et ne doivent pas être rattachés au chatbot 37. C’est le type de confusion qui transforme un POC en succès industriel dans une présentation.
Le cas norvégien mérite une place à part. Digdir ne publie pas un succès : il publie cinq défaillances observées sur 58 documents stratégiques : des références de pages fausses, un périmètre non respecté, des réponses produites même lorsque la base ne contient pas l’information 4. C’est la seule auto-évaluation publique de ce type dans le corpus. Elle vaut plus, pour un chef de projet, que dix annonces de déploiement.
Deux enseignements se dégagent. D’abord, le passage au service est une phase autonome : un prototype qui fonctionne ne devient pas un service parce qu’on le décide. Ensuite, les arrêts sont documentés, pas les causes. MILEVA a été arrêté le 31 janvier 2026 sans publier ni code, ni budget, ni statistiques d’usage 6 ; Intelligence Entreprise, à la DGE, s’est arrêté en 2022 après avoir tenté un moteur sémantique sur plus d’un million de documents 6. Ces deux arrêts disent la même chose : le besoin était réel, l’industrialisation ne l’était pas.
6. Les quatre preuves manquantes
C’est ici que le panorama cesse d’être un catalogue. Sur 23 systèmes ou projets, quatre publient un chiffre de qualité ou de bénéfice : China Maritime, China NDA (chiffre issu d’un dossier fournisseur), Seoul et Assist 13, 38, 18, 12. Aucun ne publie de protocole reproductible. Aucun n’est évalué par un tiers.
Ce que 23 systèmes et projets RAG publics documentent
Service déployé ou en usagePiloteDémoProjet documenté non documenté
| Système | Statut | Cite | Droits | Éval. |
|---|---|---|---|---|
| AIBotsSingapour | Service | citation non documentée | droits documentés | évaluation non publiée |
| AssistRoyaume-Uni | Service | citation documentée | droits non documentés | évaluation publiée |
| Leasing Desk Guide BotGSA, États-Unis | Service | citation non documentée | droits non documentés | évaluation non publiée |
| Pricing Policy ChatbotGSA, États-Unis | Pilote | citation non documentée | droits non documentés | évaluation non publiée |
| LaborMatch IQGSA, États-Unis | Projet | citation non documentée | droits non documentés | évaluation non publiée |
| AI ChatbotCaroline du Nord | Service | citation non documentée | droits non documentés | évaluation non publiée |
| nebulaONEMinnesota, États-Unis | Pilote | citation non documentée | droits non documentés | évaluation non publiée |
| Ask the EP ArchivesParlement européen | Service | citation non documentée | droits non documentés | évaluation non publiée |
| ECBotBCE | Service | citation documentée | droits non documentés | évaluation non publiée |
| RAG analyse de crisesJRC | Démo | citation non documentée | droits non documentés | évaluation non publiée |
| RAG garanties nucléairesJRC | Démo | citation non documentée | droits non documentés | évaluation non publiée |
| KIRAAllemagne | Pilote | citation documentée | droits non documentés | évaluation non publiée |
| Outil DigdirNorvège | Pilote | citation non documentée | droits non documentés | évaluation non publiée |
| Seoul Data HubCorée du Sud | Service | citation documentée | droits non documentés | évaluation publiée |
| China MaritimeChine | Service | citation documentée | droits non documentés | évaluation publiée |
| Annotation RAGChine, NDA | Service | citation non documentée | droits non documentés | évaluation publiée |
| Sanshui AssistantChine, Foshan | Service | citation non documentée | droits non documentés | évaluation non publiée |
| Policy NavigatorRwanda | Projet | citation non documentée | droits non documentés | évaluation non publiée |
| GovBotKenya | Pilote | citation documentée | droits non documentés | évaluation non publiée |
| CGU-InsightBrésil | Service | citation non documentée | droits non documentés | évaluation non publiée |
| ChatTCUBrésil | Service | citation non documentée | droits non documentés | évaluation non publiée |
| NFRA Insight BotInde | Projet | citation non documentée | droits non documentés | évaluation non publiée |
| SEABISJapon | Démo | citation documentée | droits non documentés | évaluation non publiée |
Un cinquième chiffre existe, français, hors matrice : L’Assistant, assistant généraliste, avec 75 % des agents qui le jugent utile et des gains de 12 à 16 % observés en groupes de discussion 10. Il ne change pas le constat, il le confirme : on mesure la perception, pas la fidélité documentaire.
Première preuve manquante : le rappel. Aucun cas ne publie le taux de passages pertinents retrouvés sur un jeu de questions réelles. C’est pourtant la mesure qui commande tout le reste : si le passage n’est pas dans la liste des candidats, aucun modèle, aucun reranker ne peut le ressusciter 39. Un système peut avoir l’air excellent et rater silencieusement la moitié des questions difficiles.
Deuxième preuve manquante : les permissions. Un seul cas mentionne explicitement des documents classifiés : AIBots, jusqu’au niveau Restricted / Sensitive (Normal) 14. Aucune source ne décrit l’héritage des droits jusque dans les fragments, ni le filtrage au moment de la recherche. Or OWASP place précisément ce point au centre de sa fiche sur la sécurité des RAG 40. L’écart entre l’importance du sujet et sa documentation publique est un résultat en soi, pas une lacune de recherche.
Troisième preuve manquante : le coût. Deux éléments seulement : 64 000 $ pour le pilote Minnesota 30 et une facturation au million de jetons en Caroline du Nord, sans taux publié 16. Aucun coût par document indexé, par requête ou par utilisateur actif. Toute comparaison entre architectures serait donc une estimation déguisée en résultat.
Quatrième preuve manquante : l’évaluation. Quatre cas pour 23 systèmes, aucun jeu de questions publié, aucun taux de citation exacte, aucun taux d’abstention. Sept cas documentent des citations, ce qui est mieux que rien, mais une citation affichée n’est pas une citation vérifiée 12, 24, 3, 31, 18, 34, 13.
Une précaution de lecture s’impose ici : « non documenté » ne veut pas dire « absent ». La matrice note ce que les sources disent, pas ce que les systèmes font. Un point vide signifie qu’aucune source publique ne décrit la fonction, pas qu’elle n’existe pas. C’est une différence que les lecteurs pressés confondent souvent, et qui fait dire à certains que les systèmes publics n’ont pas de permissions parce que personne ne les a décrites.
La phrase à retenir n’est pas une condamnation : le secteur public sait compter les utilisateurs ; il ne sait pas encore prouver qu’une réponse est juste. C’est un chantier, pas un verdict.
7. Pourquoi le RAG reste la bonne réponse
Si les preuves manquent, faut-il conclure que la technologie ne vaut pas l’investissement ? Non. Le RAG répond à un problème réel, et il le fait mieux que les alternatives disponibles pour des procédures qui changent.
Il rend la réponse vérifiable. Un modèle seul produit un texte plausible ; un RAG produit un texte accompagné des passages qui l’ont fondé. L’agent peut ouvrir le document, vérifier la page, contester. C’est la différence entre une réponse et une affirmation 19.
Il permet d’ajouter un document sans réentraîner le modèle. Une procédure publiée aujourd’hui peut être indexée demain. C’est ce qui rend le RAG adapté à un corpus vivant, contrairement à un affinage qui modifie le comportement du modèle sans garantir la fraîcheur 19.
Il ne faut pas le confondre avec deux autres choses. Le RAG n’est pas l’affinage : l’un apporte des documents, l’autre modifie le comportement. Le RAG n’est pas non plus l’agentique : GOV.UK recommande le RAG classique par défaut, et présente l’agentique comme plus long, plus cher et plus difficile à déboguer 20. Ce sont des choix d’architecture, pas des degrés de modernité.
Les cas qui fonctionnent sont bornés. Assist travaille sur cinq documents maintenus 12 ; China Maritime sur une base de 5 488 questions-réponses 13 ; la Caroline du Nord sur le contenu public des sites d’agences 16. Aucun ne prétend couvrir « toute la connaissance de l’administration ». Le périmètre étroit n’est pas une limite du RAG : c’est sa condition de réussite.
Reste une question que le panorama ne tranche pas : le RAG est-il la bonne réponse pour chaque besoin ? Non. Pour une question dont la réponse tient dans une fiche structurée, une recherche classique suffit. Pour une synthèse sur un corpus instable, un RAG mal gouverné ajoutera de la confiance à des erreurs. La technologie est adaptée quand la réponse doit être ancrée, citée et mise à jour, pas quand elle doit être simplement fluide.
8. Ce que cela change pour un projet public
Le rapport IGF–IGAS–IGA formule treize propositions pour le déploiement de l’IA dans les administrations : cartographie des cas d’usage, intégration aux systèmes d’information, réversibilité, formation, gouvernance 41. Une architecture documentaire bien conçue sert directement plusieurs d’entre elles. Elle ne les remplace pas.
Cinq décisions pèsent plus que le choix du modèle.
1. Un périmètre étroit et métier. Un corpus, un métier, une équipe qui le maintient. Le contraire, « toutes les connaissances de la collectivité », produit un index sans autorité et une réponse sans responsable.
2. Un jeu de questions réel, avant l’outil. Cinquante à deux cents questions posées par de vrais agents, dont environ 20 % auxquelles le corpus ne permet pas de répondre 42. Sans questions non répondables, on ne mesure pas l’abstention ; on mesure la politesse du modèle.
3. Le rappel avant la génération. Mesurer si les bons passages sont retrouvés, séparément de la qualité rédactionnelle. Un système qui répond bien à partir de mauvais passages est un générateur de confiance, pas un outil documentaire 39.
4. Une validation humaine sur les usages sensibles. Les cas qui la mentionnent (China Maritime, JRC, Digdir) la présentent comme nécessaire, pas comme un reste de transition 13 33, 4. Un RAG qui produit une décision sans relecture n’est plus un assistant.
5. Des critères d’arrêt écrits d’avance. MILEVA et Intelligence Entreprise se sont arrêtés 6 ; Minnesota a clos son pilote sans bilan 30. Un projet doit dire, avant de commencer, ce qui le ferait arrêter : un rappel insuffisant, un coût par requête hors budget, une maintenance documentaire non financée.
Les cinq questions à poser avant de signer
- Quel corpus exact, maintenu par qui, à quelle fréquence ?
- Sur quelles questions réelles serez-vous évalué, et combien sont non répondables ?
- Comment les droits d’accès sont-ils portés par les fragments et filtrés à la recherche ?
- Quel taux de citation exacte et quel taux d’abstention acceptez-vous ?
- Quel est le coût par document indexé et par requête, et qui paie la mise à jour ?
La cinquième question est celle qu’on oublie le plus vite. Un index n’est pas un investissement ponctuel : c’est un abonnement documentaire. Assist ne tient que parce que cinq documents sont explicitement maintenus 12 ; AIBots ne tient que parce que les agences versent et actualisent leurs corpus 14. Supprimer le budget de maintenance, c’est programmer un index qui se dégrade sans que personne ne s’en aperçoive.
Aucune de ces questions ne porte sur le modèle. C’est le point : le modèle est la partie la plus visible et la moins décisive du projet.
9. Ce que la série va montrer
Cet article a posé le décor et la thèse. Les quatre suivants ouvrent le capot, chacun avec une seule question.
| Article | Question | Ce qu’il apportera |
|---|---|---|
| 2. Comment fonctionne réellement un RAG documentaire ? | Que se passe-t-il entre un PDF et une réponse citée ? | OCR, structure, chunking, recherche hybride, reranking, citations |
| 3. Sécuriser un RAG : permissions, injections et confidentialité | Que doit démontrer un système avant qu’un RSSI l’autorise ? | permissions par fragment, injection indirecte, cycle de vie, souveraineté |
| 4. Pourquoi les projets RAG échouent en production | Qu’est-ce qui casse, et comment le mesurer avant de promettre ? | arrêts, qualité documentaire, évaluation, coûts, observabilité |
| 5. Construire un assistant documentaire fiable, de A à Z | Quels choix concrets, avec quels compromis ? | corpus, dépôt, tests, démonstration, décisions d’architecture |
Les quatre preuves manquantes ne sont pas une condamnation du RAG. Ce sont les quatre chantiers des articles suivants : la mécanique (article 2), la sécurité (article 3), la mesure (article 4) et la construction (article 5).
10. Conclusion
Le RAG transforme réellement l’accès aux connaissances dans les administrations : il rend interrogeable ce qui était dispersé, et il rend vérifiable ce qui était affirmé. Mais la transformation n’est pas là où on l’attend. Elle n’est pas dans le modèle, dont les versions se succèdent. Elle est dans la documentation : un corpus identifié, versionné, dont les droits sont connus et dont la qualité est mesurée.
C’est la leçon des 23 systèmes recensés. Les mieux documentés ne sont pas les plus spectaculaires ; ce sont ceux dont on peut dire, précisément, ce qu’ils font, sur quoi, pour qui, et avec quelles limites. Les autres produisent des chiffres d’usage et laissent la question la plus importante sans réponse : la réponse était-elle juste ?
Chez Seshat, nous appliquons cette règle à nos propres travaux : distinguer ce qui est disponible, ce qui est expérimental et ce qui n’est pas mesuré. Un système documentaire qui ne peut pas dire d’où vient sa réponse n’est pas un progrès ; c’est une boîte noire de plus.
Sources
- Cour des comptes, enquête sur les Archives nationales. lien
- Archives nationales, rapport d’activité 2025. lien
- BDBOS / ASDN (Basse-Saxe, Allemagne), KIRA. lien
- Digdir (Norvège), KI-verktøy for identifisering av digitaliseringstiltak. lien
- Ministério da Gestão e da Inovação (Brésil), Guia de introdução ao RAG no setor público. lien
- Fiches beta.gouv.fr (état des projets). lien
- Cour des comptes, Mieux suivre et valoriser les gains de productivité de l’État issus du numérique. lien
- El Paso, chatbot Ask Laura. lien
- GovTech Singapour, Pair. lien
- DITP / DINUM, L’Assistant IA : bilan de l’expérimentation menée auprès des agents. lien
- Open Contracting Partnership, AI in public procurement. lien
- Cabinet Office (Royaume-Uni), Assist — registre de transparence algorithmique. lien
- Ministère des Transports (Chine), China Maritime Intelligent Customer Service. lien
- GovTech Singapour, AIBots. lien
- Hansel (Finlande), Hankintavälkky dans le portail Hilma. lien
- NCDIT (Caroline du Nord), AI Chatbot. lien
- Albert API (DINUM / Etalab). lien
- Ville de Séoul, Seoul Data Hub. lien
- GOV.UK / GDS, AI Insights: RAG Systems. lien
- GOV.UK / GDS, AI Insights: Agentic RAG. lien
- RISA (Rwanda), GoR AI-Powered Policy Navigator. lien
- Localtis / Banque des Territoires, collectivités et IA générative. lien
- Parlement européen, Ask the EP Archives. lien
- BCE, ECBot — déclaration de confidentialité et description technique. lien
- GSA (États-Unis), 2025 GSA AI use cases. lien
- U.S. Federal AI Observatory, miroir analytique de l’inventaire OMB 2025. lien
- GAO (États-Unis), Generative AI Use and Management at Federal Agencies. lien
- NARA (États-Unis), inventaire des cas d’usage d’IA. lien
- US Department of Labor, inventaire des cas d’usage. lien
- Minnesota IT Services (MNIT), projet TMF nebulaONE. lien
- GovStack, GovBot — AI Chatbot for Discoverability of Government Services (Kenya). lien
- JRC (Commission européenne), AI applied to disasters and crises management. lien
- JRC (Commission européenne), Applying Generative AI to Enhance Nuclear Safeguards Information Analysis. lien
- Agence numérique du Japon, atelier Co-creation PF Camp (SEABIS). lien
- IndiaAI / NFRA, Financial Reporting Compliance Challenge. lien
- Network Rail (Royaume-Uni), chatbot RAG sur les leçons apprises. lien
- Network Rail, stratégie data Wales & Western (APM). lien
- Administration nationale des données (Chine), cas d’annotation par RAG. lien
- Late interaction et reranking. lien
- OWASP, Top 10 for LLM Applications 2026 et RAG Security Cheat Sheet. lien
- IGF, IGAS et IGA (rapport conjoint), Le déploiement de l’intelligence artificielle dans les administrations publiques : analyse comparée, enjeux et conditions de réussite. lien
- Évaluation. lien